Un attacco non colpisce più soltanto un computer
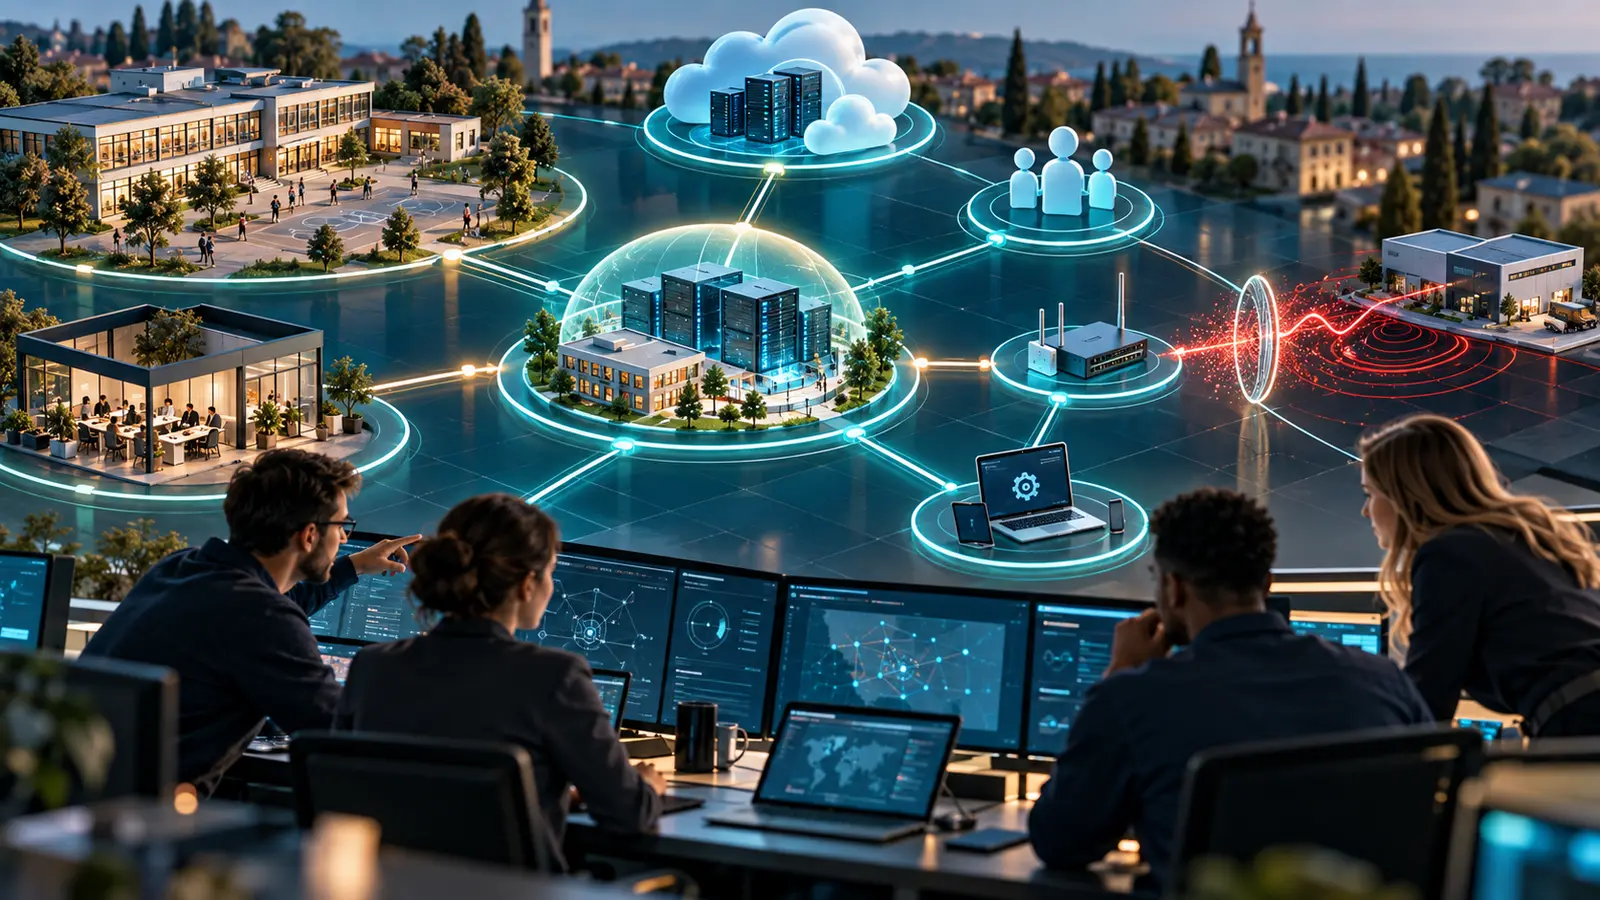
Il rapporto ENISA Threat Landscape 2026, pubblicato il 22 settembre, descrive un ecosistema nel quale servizi cloud, software, identità digitali, fornitori e infrastrutture condivise sono collegati tra loro. Questa interconnessione crea efficienza, ma permette anche a un singolo problema di propagarsi: l’indisponibilità di un provider, la compromissione di un account amministrativo o una vulnerabilità in un componente comune possono fermare più servizi contemporaneamente.
ENISA ha raccolto e analizzato 8.257 incidenti riferiti al periodo dal 1° gennaio al 31 dicembre 2025. Il dato non rappresenta tutti gli attacchi avvenuti in Europa: deriva da fonti aperte e informazioni condivise, quindi va letto come una fotografia ragionata delle tendenze osservabili. Proprio questa cautela rende il rapporto utile: non produce una classifica da copiare, ma indica dove cercare le dipendenze che trasformano un guasto o un attacco in un’interruzione estesa.
- DDoS: 51,3% degli incidenti classificati nel dataset ENISA.
- Accessi non autorizzati: 39,5% degli incidenti osservati.
- Phishing: 77,8% delle tecniche di ingegneria sociale rilevate.
- Ransomware: resta la tipologia di incidente con l’impatto più forte nel breve periodo.
Il vero perimetro è la catena dei servizi
Per una scuola il registro elettronico, la posta, la connettività, il DNS, l’autenticazione, i laboratori, le piattaforme didattiche e i backup possono dipendere da soggetti differenti. In una piccola impresa la stessa catena comprende gestionale, fatturazione, CRM, cloud, banca, posta e accesso remoto. Disegnare soltanto la rete interna non basta più: occorre rappresentare il servizio dall’utente fino ai fornitori esterni.
La prima domanda pratica è: “Se questo elemento non fosse disponibile per un giorno, quali attività si fermerebbero?”. La seconda è: “Se questo account fosse compromesso, a quali altri sistemi consentirebbe di accedere?”. Le risposte fanno emergere nodi critici spesso invisibili, come una sola casella email usata per recuperare tutte le password, un unico dominio che controlla più servizi o un fornitore dal quale non è possibile esportare rapidamente i dati.
- Servizio essenziale: che cosa deve continuare a funzionare per erogare lezioni o lavorare?
- Dipendenza tecnica: rete, DNS, identità, cloud, software, dispositivo o integrazione.
- Dipendenza organizzativa: una sola persona possiede accessi o conoscenze indispensabili?
- Dipendenza contrattuale: esistono tempi di ripristino, esportazione dati e assistenza definiti?
- Alternativa: è disponibile una procedura temporanea se il servizio principale si interrompe?
DDoS e indisponibilità: proteggere il servizio, non soltanto il server
Nel dataset ENISA i DDoS sono la categoria più numerosa. La pubblica amministrazione è il settore più colpito, con il 32% dei casi, e l’82% degli eventi osservati in quel settore è riconducibile a campagne DDoS. Questi numeri risentono della maggiore visibilità degli attacchi di indisponibilità, ma ricordano che la continuità è parte integrante della sicurezza.
Una scuola o una PMI non deve necessariamente acquistare una piattaforma complessa. Deve però conoscere i servizi esposti, verificare se il provider offre protezione e scalabilità, separare il sito pubblico dai sistemi amministrativi e predisporre un canale alternativo per comunicazioni urgenti. Se lo stesso dominio, lo stesso DNS o lo stesso account amministrativo controllano tutto, la ridondanza apparente può non essere reale.
- Elenca siti, VPN, servizi remoti e portali raggiungibili da Internet.
- Verifica protezione DDoS, limiti, contatti di emergenza e tempi di intervento del provider.
- Mantieni un canale alternativo già noto per comunicare durante un’interruzione.
- Controlla che sito pubblico e servizi interni non condividano inutilmente lo stesso punto di guasto.
Ransomware: il backup conta soltanto quando riparte
Il ransomware continua a produrre l’impatto immediato più grave perché unisce indisponibilità, furto di dati ed estorsione. Una copia automatica nello stesso ambiente non garantisce il recupero: può essere cifrata, cancellata o sincronizzare dati già compromessi. La resilienza richiede copie separate, accessi distinti, versioni protette e prove di ripristino.
Il test deve partire da un servizio concreto. Non basta verificare che il file sia presente: occorre ripristinare dati, applicazione, configurazione e permessi in un ambiente controllato, misurando tempo e dipendenze. Una prova trimestrale su un campione critico rivela password mancanti, procedure obsolete, licenze non disponibili e backup formalmente riusciti ma inutilizzabili.
- Definisci quali dati e configurazioni servono per riavviare ogni servizio prioritario.
- Mantieni almeno una copia non modificabile dall’account ordinario di amministrazione.
- Registra obiettivo di perdita dati accettabile e tempo massimo di ripristino.
- Esegui una prova documentata e correggi ciò che impedisce il ritorno operativo.
Identità: una sola credenziale può diventare una dipendenza critica
Quando posta, cloud, gestionali e assistenza condividono la stessa identità, la compromissione di un account può attraversare l’intera organizzazione. Il phishing resta la tecnica di ingegneria sociale dominante nel rapporto ENISA, ma la difesa non può limitarsi a riconoscere un messaggio sospetto: deve ridurre ciò che un singolo account può fare.
Gli amministratori devono usare account separati da quelli quotidiani, autenticazione resistente al phishing quando disponibile e procedure di recupero che non dipendano da una sola persona o casella. È utile controllare periodicamente privilegi, account inattivi, applicazioni collegate e metodi di recupero. Il principio è semplice: un’identità compromessa non deve equivalere al controllo di tutto.
- Account distinti per attività ordinaria e amministrazione.
- MFA obbligatoria, preferibilmente con passkey o chiavi di sicurezza per gli accessi privilegiati.
- Privilegi minimi e revisione periodica di ruoli, deleghe e account inattivi.
- Almeno due amministratori autorizzati e procedura di recupero verificata.
Fornitori e cloud: fare domande prima dell’emergenza
ENISA sottolinea l’effetto a cascata degli incidenti che coinvolgono fornitori software, prestatori di servizi e ambienti cloud. Il rischio non si elimina evitando il cloud: si gestisce conoscendo responsabilità, dipendenze e possibilità di uscita. Anche un servizio affidabile può subire un’interruzione o cambiare condizioni, quindi la continuità non può essere completamente delegata.
Prima di adottare una piattaforma vanno chiariti autenticazione, logging, backup, esportazione, cancellazione, gestione delle vulnerabilità, subfornitori e comunicazione degli incidenti. Le risposte devono diventare requisiti verificabili, non formule commerciali. Per i servizi essenziali è importante provare almeno una volta l’esportazione dei dati e sapere quanto tempo richiederebbe migrare o lavorare temporaneamente senza il fornitore.
- Chi può accedere ai dati e con quali controlli di autenticazione?
- Quali log sono disponibili, per quanto tempo e senza costi aggiuntivi imprevisti?
- Come si esportano dati, configurazioni e allegati in un formato riutilizzabile?
- Come e quando vengono comunicati incidenti, vulnerabilità e indisponibilità?
- Qual è il piano operativo se il contratto termina o il servizio non è raggiungibile?
Una verifica pratica in 90 minuti
La resilienza può essere allenata senza bloccare l’organizzazione. Riunisci direzione, referente tecnico e responsabili dei processi, scegli un servizio essenziale e simula un’interruzione realistica: posta non disponibile, account amministratore compromesso, gestionale irraggiungibile o fornitore cloud fermo.
Durante la prova non cercare colpe. Ricostruisci decisioni, contatti, credenziali, copie disponibili e comunicazioni. Alla fine assegna ogni correzione a una persona con una scadenza. Il valore dell’esercitazione non è dimostrare che il piano è perfetto, ma scoprire prima dell’incidente dove mancano informazioni o alternative.
- 0–15 minuti: descrivi scenario, impatto e servizi coinvolti.
- 15–35 minuti: individua dipendenze tecniche, persone e fornitori necessari.
- 35–55 minuti: prova contatti, accessi di emergenza e disponibilità delle copie.
- 55–75 minuti: definisci continuità minima e messaggi per utenti, clienti o famiglie.
- 75–90 minuti: registra tre correzioni, responsabili e date di verifica.
Un piano di miglioramento in quattro settimane
Il rapporto ENISA non richiede di inseguire ogni minaccia. Suggerisce di osservare l’intero ecosistema e ridurre i punti nei quali una dipendenza può moltiplicare l’impatto. Per una realtà con risorse limitate è più efficace completare poche azioni verificabili che accumulare strumenti non coordinati.
Il modello di maturità per le PMI pubblicato da ENISA nel luglio 2026 rafforza questo approccio: valutare lo stato attuale, individuare miglioramenti proporzionati e raccogliere evidenze del loro funzionamento. La stessa logica è utile anche a scuole e organizzazioni che non producono software.
- Settimana 1: mappa cinque servizi essenziali e le rispettive dipendenze.
- Settimana 2: correggi account privilegiati, MFA, recupero e accessi inattivi.
- Settimana 3: prova il ripristino di un servizio e l’esportazione da un fornitore.
- Settimana 4: esegui una simulazione di 90 minuti e approva le priorità successive.
La resilienza comincia da ciò che non puoi permetterti di perdere
Gli 8.257 incidenti analizzati da ENISA non devono alimentare allarmismo. Servono a cambiare prospettiva: proteggere singoli dispositivi è necessario, ma la continuità dipende dalle relazioni tra identità, dati, software, rete, cloud, fornitori e persone.
Se vuoi mappare le dipendenze digitali della tua scuola o impresa, verificare backup e accessi o costruire un’esercitazione di continuità, posso aiutarti a trasformare il rischio in un piano tecnico concreto e misurabile. Contattami per partire dai servizi che devono funzionare davvero, anche quando qualcosa va storto.
Progettiamo formazione, procedure e strumenti adatti alla tua scuola o attività.